Domain casl.de kaufen?
Wir ziehen mit dem Projekt
casl.de um.
Sind Sie am Kauf der Domain
casl.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain casl.de kaufen?
Wie funktioniert das Double-Opt-in Verfahren und warum ist es wichtig für die Einwilligung von E-Mail-Marketing?
Das Double-Opt-in Verfahren beinhaltet, dass Nutzer nach der Anmeldung für den E-Mail-Newsletter eine Bestätigungs-E-Mail erhalten und erst nach Klick auf den Bestätigungslink endgültig eingetragen werden. Dies dient dazu, sicherzustellen, dass die Anmeldung tatsächlich vom Nutzer gewollt ist und verhindert unerwünschte Spam-Anmeldungen. Durch das Double-Opt-in Verfahren wird die Einwilligung der Nutzer für den Erhalt von E-Mail-Marketing bestätigt und somit die rechtliche Grundlage für den Versand geschaffen. **
Wie beeinflusst Data Mining die Geschäftsstrategie und das Marketing in verschiedenen Branchen?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster zu identifizieren, die ihnen helfen, fundierte Geschäftsentscheidungen zu treffen. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Finanzbranche kann Data Mining eingesetzt werden, um Betrugsmuster zu erkennen und Risikomanagementstrategien zu verbessern. In der Gesundheitsbranche kann Data Mining genutzt werden, um Krankheitsmuster zu identifizieren und die Effektivität von Behandlungen zu verbessern. Insgesamt kann Data Mining in verschiedenen Branchen dazu beitragen, die Geschäftsstrategie zu optimieren und das Marketing effektiver zu gestalten. **
Ähnliche Suchbegriffe für Cleve-Jürgen-Data-Mining
Top-Angebote
Produkte zum Begriff Cleve-Jürgen-Data-Mining:
-
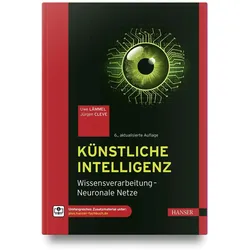
Künstliche Intelligenz, Fachbücher von Uwe Lämmel, Jürgen CleveKünstliche Intelligenz (KI) ganz praktisch - Symbolverarbeitende künstliche Intelligenz und künstliche neuronale Netze in einem Buch - Business Rules und Wissensnetze - Convolutional Neural Networks und Deep Learning - Übungen in Prolog sowie mit JavaNNS und Python Die künstliche Intelligenz hat unseren Alltag erreicht: Wir nutzen Chatbots, reden mit Sprachassistenten, KI digitalisiert die Dokumentenverarbeitung, die Muster-, Bild- oder Objekterkennung. Sie ermöglicht neue, intelligentere Lösungen in vielen Bereichen, von der Medizin bis zum autonomen Fahren. Das Buch gibt eine Einführung in die KI. Es wird gezeigt, wie symbolverarbeitende KI in Form von Wissensnetzen oder Geschäftsregeln heute angewendet und wie künstliche neuronale Netze in der Mustererkennung oder auch im Data Mining eingesetzt werden können. Wissensrepräsentation und -verarbeitung auf Basis der Logik wird unter Nutzung der logischen Programmiersprache Prolog eingeführt. Logische Schlussfolgerungen lassen sich in Prolog wesentlich leichter als in Python oder Java implementieren. Die Konzepte neuronaler Netze werden mit dem System JavaNNS und mittels Python praktisch vertieft. Fragen und Aufgaben am Ende eines Abschnitts fordern zum aktiven Lesen und Lernen auf. Die Webseiten zum Buch enthalten Demo-Programme, die diskutierte Vorgehensweisen veranschaulichen und das Verständnis fördern. Aus dem Inhalt: - Überblick zur künstlichen Intelligenz - Darstellung und Verarbeitung von Wissen - Problemlösung mittels Suche - Wissensverarbeitung mit Prolog - Künstliche neuronale Netze - Vorwärtsgerichtete neuronale Netze - Wettbewerbslernen - Autoassoziative Netze - Entwicklung neuronaler Netze Neu in der 6. Auflage sind Abschnitte zu den Themen ChatGPT sowie Decision Model and Notation (DMN) bei Prozessbeschreibungen.34,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Brockmeyer:Text und Data Mining, Fachbücher von Henning BrockmeyerZum Werk Weltweit werden täglich grosse Datenbestände erzeugt. Diese enthalten eine Vielzahl an Informationen, aus denen sich viele Zusammenhänge, d.h. idealerweise neue Erkenntnisse und damit neues Wissen, ableiten lassen. Letzteres ist dem Menschen aufgrund der schieren Menge an gespeicherten Informationen selbst nicht mehr ohne weiteres möglich, weshalb er sich im Rahmen der computergestützten Datenanalyse bestimmter Algorithmen bedient. Dieses Vorgehen wird schlagwortartig abhängig von der auszuwertenden Datengrundlage als Text und Data Mining bezeichnet. Anwenderinnen und Anwender des Text und Data Mining stehen regelmässig vor der Herausforderung, eine auswertbare Datengrundlage zu generieren. Sie brauchen Zugang zu Texten und Daten, an denen aber Urheber- und Datenbankhersteller die Rechte, insbesondere das für die computergestützte Auswertung relevante Vervielfältigungsrecht haben. Die Europäische Union hat im Rahmen der Richtlinie über den digitalen Binnenmarkt Vorgaben für den Ausgleich der vorgenannten widerstreitenden Interessen zwischen Rechteinhabern und TDM-Anwendern gemacht, die auch der deutsche Gesetzgeber umgesetzt hat. Da der durch den Gesetzgeber vorgenommene Interessenausgleich relevante rechtsökonomische Folgen für alle Beteiligten hat, ist zu hinterfragen, inwieweit dieser gelungen ist. Vorteile auf einen Blick: - Analyse der bisherigen und der neuen urheberrechtlichen Regelung in Deutschland - Analyse der europäischen Vorgaben - Überblick über Regelungsalternativen in anderen Rechtsordnungen Zielgruppe Für Juristinnen und Juristen aus Wissenschaft und Praxis sowie interessiertes Fachpublikum aus anderen Disziplinen.49,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Learning Analytics, Artificial Intelligence und Data Mining in der Hochschulbildung, Fachbücher von Jonas Leschke, Malte Persike, Robert QueckenbergDas Fachbuch "Learning Analytics, Artificial Intelligence und Data Mining in der Hochschulbildung" bietet eine umfassende Analyse der Anwendung moderner Technologien im Bildungsbereich. Es richtet sich an Fachleute, Studierende und Interessierte, die sich mit den Möglichkeiten und Herausforderungen von Learning Analytics und Künstlicher Intelligenz in der Hochschulbildung auseinandersetzen möchten. Die Beiträge, die im Rahmen der Learning AID 2024 entstanden sind, beleuchten verschiedene Aspekte der Datenanalyse und deren Einfluss auf Lehr- und Lernprozesse. Mit einem kartonierten Einband und einer Seitenanzahl von 240 bietet das Buch eine fundierte Grundlage für die Diskussion über die Integration von Data Mining-Techniken in die Hochschulbildung. Die Autoren Robert Queckenberg und Malte Persike bringen ihre Expertise ein, um die Leser über aktuelle Trends und Entwicklungen zu informieren. Verfasst in deutscher Sprache, ist das Buch im Jahr 2025 erschienen und stammt aus Deutschland. Es ist ein wertvolles Werk für alle, die sich mit den geisteswissenschaftlichen Perspektiven auf digitale Bildungstechnologien beschäftigen.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann ein Unternehmen einen rechtskonformen Opt-in-Prozess für die Einwilligung in E-Mail-Marketing aufbauen?
Ein Unternehmen sollte sicherstellen, dass die Einwilligung freiwillig, spezifisch, informiert und eindeutig ist. Dies kann durch die Verwendung eines klaren und verständlichen Opt-in-Formulars erreicht werden. Zudem sollte das Unternehmen eine Dokumentation über den Einwilligungsprozess führen, um im Falle einer Überprüfung durch die Aufsichtsbehörden nachweisen zu können, dass die Einwilligung rechtskonform eingeholt wurde. **
-
Wie funktioniert das Double-Opt-in-Verfahren und warum ist es wichtig für die Zustimmung zu Marketing-E-Mails?
Das Double-Opt-in-Verfahren beinhaltet, dass Nutzer nach der Anmeldung für Marketing-E-Mails eine Bestätigungs-E-Mail erhalten und erst nach Klick auf den Bestätigungslink endgültig in den Verteiler aufgenommen werden. Dies dient dazu, sicherzustellen, dass die Anmeldung tatsächlich vom Nutzer selbst stammt und nicht missbräuchlich erfolgt ist. Durch das Double-Opt-in-Verfahren wird die Zustimmung des Nutzers zu Marketing-E-Mails rechtlich abgesichert und die Wahrscheinlichkeit von Spam-Beschwerden reduziert. **
-
Was ist der Unterschied zwischen Opt-In und Opt-Out bei der Einwilligung in Marketing-Kommunikation?
Opt-In bedeutet, dass der Kunde aktiv zustimmen muss, um Marketing-Kommunikation zu erhalten. Opt-Out bedeutet, dass der Kunde automatisch Marketing-Kommunikation erhält, es sei denn, er widerspricht ausdrücklich. Opt-In ist also eine aktive Zustimmung, während Opt-Out eine passive Zustimmung ist. **
-
Wie beeinflusst Data Mining die Geschäftsstrategie in verschiedenen Branchen und wie können Unternehmen von den Erkenntnissen profitieren, die durch Data Mining gewonnen werden?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster sowie Trends zu identifizieren, die für ihre Branche relevant sind. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, um das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Gesundheitsbranche können durch Data Mining Krankheitsmuster erkannt und präventive Maßnahmen entwickelt werden. Unternehmen können von den Erkenntnissen, die durch Data Mining gewonnen werden, profitieren, indem sie fundierte Entscheidungen treffen, ihre Effizienz steigern und ihre Wettbewerbsfähigkeit stärken. Durch die Nutzung von Data Mining können Unternehmen auch neue Geschäftsmöglichkeiten identifizieren und innovative Produkte oder Dienstleistungen entwickeln, die den Bedürfnissen ihrer Kunden **

Wie kann Data Mining dazu beitragen, Muster und Erkenntnisse in großen Datensätzen zu entdecken? Welche Methoden und Techniken werden beim Data Mining eingesetzt?
Data Mining kann dabei helfen, versteckte Muster und Erkenntnisse in großen Datensätzen aufzudecken, indem Algorithmen angewendet werden, um die Daten zu analysieren und Zusammenhänge zu identifizieren. Zu den Methoden und Techniken, die beim Data Mining eingesetzt werden, gehören Clustering, Klassifizierung, Regression, Assoziationsanalyse und Anomalieerkennung. Durch diese Techniken können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. **
Warum ist das Double-Opt-in Verfahren wichtig, wenn es um die Zustimmung von Abonnenten für Newsletter und Werbe-E-Mails geht?
Das Double-Opt-in Verfahren stellt sicher, dass die Zustimmung des Abonnenten wirklich absichtlich und bewusst erfolgt. Es schützt vor unerwünschter Spam und sorgt für eine höhere Qualität der Abonnentenliste. Zudem entspricht es den rechtlichen Anforderungen zum Schutz personenbezogener Daten. **
Top-Angebote
Produkte zum Begriff Cleve-Jürgen-Data-Mining:
-
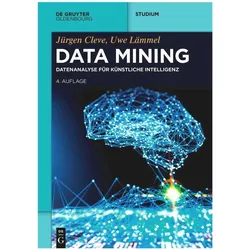
Cleve:Data Mining, Fachbücher von Uwe Lämmel, Jürgen CleveData Mining liefert Grundlagen für die Künstliche Intelligenz, indem es Technologien für die Analyse grosser Datenmengen bereitstellt. Das Buch deckt den Stoff einer einsemestrigen Vorlesung an Universitäten oder Fachhochschulen ab und ist als klassisches Lehrbuch konzipiert. Es bietet eine Einführung in die wesentlichen Anwendungsgebiete und behandelt die zugehörigen Algorithmen. Die Beispiele und Aufgaben können mit frei verfügbaren Werkzeugen bearbeitet werden. Die vierte Auflage enthält inhaltliche Erweiterungen und Aktualisierungen. Data Mining bietet Methoden und Algorithmen zur Entdeckung zuvor unbekannter Korrelationen in grossen Datenmengen. Dieses Buch behandelt das Material einer einsemestrigen Vorlesung an Universitäten und ist als klassisches Lehrbuch gestaltet. Diese vierte überarbeitete und aktualisierte Auflage berücksichtigt die neuesten Entwicklungen in den Bereichen KI, Big Data, Data Science und maschinelles Lernen.79,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Evolutionary Computation in Data Mining, Fachbücher von Ashish GhoshData Mining (DM) besteht darin, interessante Erkenntnisse aus realen, grossen und komplexen Datensätzen zu extrahieren und ist der zentrale Schritt eines umfassenderen Prozesses, der als Wissensentdeckung aus Datenbanken (KDD) bezeichnet wird. Neben dem DM-Schritt, der Wissen aus Daten extrahiert, umfasst der KDD-Prozess mehrere Vorverarbeitungs- (oder Datenvorbereitungs-) und Nachbearbeitungsschritte (oder Wissensverfeinerung). Das Ziel der Methoden zur Datenvorverarbeitung besteht darin, die Daten so zu transformieren, dass die Anwendung eines oder mehrerer gegebener DM-Algorithmen erleichtert wird, während das Ziel der Methoden zur Wissensverfeinerung darin besteht, entdecktes Wissen zu validieren und zu verfeinern. Idealerweise sollte das entdeckte Wissen nicht nur genau, sondern auch verständlich und interessant für den Benutzer sein. Der gesamte Prozess ist sehr rechenintensiv. Die Idee, Wissen automatisch aus Datenbanken zu entdecken, ist eine sehr attraktive und herausfordernde Aufgabe, sowohl für die Wissenschaft als auch für die Industrie. Daher gibt es ein wachsendes Interesse an Data Mining in mehreren KI-bezogenen Bereichen, einschliesslich evolutionärer Algorithmen (EAs). Die Hauptmotivation für die Anwendung von EAs auf KDD-Aufgaben besteht darin, dass sie robuste und adaptive Suchmethoden sind, die eine globale Suche im Raum der Kandidatenlösungen, wie Regeln oder andere Formen der Wissensdarstellung, durchführen.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Künstliche Intelligenz, Fachbücher von Uwe Lämmel, Jürgen CleveKünstliche Intelligenz (KI) ganz praktisch - Symbolverarbeitende künstliche Intelligenz und künstliche neuronale Netze in einem Buch - Business Rules und Wissensnetze - Convolutional Neural Networks und Deep Learning - Übungen in Prolog sowie mit JavaNNS und Python Die künstliche Intelligenz hat unseren Alltag erreicht: Wir nutzen Chatbots, reden mit Sprachassistenten, KI digitalisiert die Dokumentenverarbeitung, die Muster-, Bild- oder Objekterkennung. Sie ermöglicht neue, intelligentere Lösungen in vielen Bereichen, von der Medizin bis zum autonomen Fahren. Das Buch gibt eine Einführung in die KI. Es wird gezeigt, wie symbolverarbeitende KI in Form von Wissensnetzen oder Geschäftsregeln heute angewendet und wie künstliche neuronale Netze in der Mustererkennung oder auch im Data Mining eingesetzt werden können. Wissensrepräsentation und -verarbeitung auf Basis der Logik wird unter Nutzung der logischen Programmiersprache Prolog eingeführt. Logische Schlussfolgerungen lassen sich in Prolog wesentlich leichter als in Python oder Java implementieren. Die Konzepte neuronaler Netze werden mit dem System JavaNNS und mittels Python praktisch vertieft. Fragen und Aufgaben am Ende eines Abschnitts fordern zum aktiven Lesen und Lernen auf. Die Webseiten zum Buch enthalten Demo-Programme, die diskutierte Vorgehensweisen veranschaulichen und das Verständnis fördern. Aus dem Inhalt: - Überblick zur künstlichen Intelligenz - Darstellung und Verarbeitung von Wissen - Problemlösung mittels Suche - Wissensverarbeitung mit Prolog - Künstliche neuronale Netze - Vorwärtsgerichtete neuronale Netze - Wettbewerbslernen - Autoassoziative Netze - Entwicklung neuronaler Netze Neu in der 6. Auflage sind Abschnitte zu den Themen ChatGPT sowie Decision Model and Notation (DMN) bei Prozessbeschreibungen.34,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Brockmeyer:Text und Data Mining, Fachbücher von Henning BrockmeyerZum Werk Weltweit werden täglich grosse Datenbestände erzeugt. Diese enthalten eine Vielzahl an Informationen, aus denen sich viele Zusammenhänge, d.h. idealerweise neue Erkenntnisse und damit neues Wissen, ableiten lassen. Letzteres ist dem Menschen aufgrund der schieren Menge an gespeicherten Informationen selbst nicht mehr ohne weiteres möglich, weshalb er sich im Rahmen der computergestützten Datenanalyse bestimmter Algorithmen bedient. Dieses Vorgehen wird schlagwortartig abhängig von der auszuwertenden Datengrundlage als Text und Data Mining bezeichnet. Anwenderinnen und Anwender des Text und Data Mining stehen regelmässig vor der Herausforderung, eine auswertbare Datengrundlage zu generieren. Sie brauchen Zugang zu Texten und Daten, an denen aber Urheber- und Datenbankhersteller die Rechte, insbesondere das für die computergestützte Auswertung relevante Vervielfältigungsrecht haben. Die Europäische Union hat im Rahmen der Richtlinie über den digitalen Binnenmarkt Vorgaben für den Ausgleich der vorgenannten widerstreitenden Interessen zwischen Rechteinhabern und TDM-Anwendern gemacht, die auch der deutsche Gesetzgeber umgesetzt hat. Da der durch den Gesetzgeber vorgenommene Interessenausgleich relevante rechtsökonomische Folgen für alle Beteiligten hat, ist zu hinterfragen, inwieweit dieser gelungen ist. Vorteile auf einen Blick: - Analyse der bisherigen und der neuen urheberrechtlichen Regelung in Deutschland - Analyse der europäischen Vorgaben - Überblick über Regelungsalternativen in anderen Rechtsordnungen Zielgruppe Für Juristinnen und Juristen aus Wissenschaft und Praxis sowie interessiertes Fachpublikum aus anderen Disziplinen.49,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert das Double-Opt-in Verfahren und warum ist es wichtig für die Einwilligung von E-Mail-Marketing?
Das Double-Opt-in Verfahren beinhaltet, dass Nutzer nach der Anmeldung für den E-Mail-Newsletter eine Bestätigungs-E-Mail erhalten und erst nach Klick auf den Bestätigungslink endgültig eingetragen werden. Dies dient dazu, sicherzustellen, dass die Anmeldung tatsächlich vom Nutzer gewollt ist und verhindert unerwünschte Spam-Anmeldungen. Durch das Double-Opt-in Verfahren wird die Einwilligung der Nutzer für den Erhalt von E-Mail-Marketing bestätigt und somit die rechtliche Grundlage für den Versand geschaffen. **
-
Wie beeinflusst Data Mining die Geschäftsstrategie und das Marketing in verschiedenen Branchen?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster zu identifizieren, die ihnen helfen, fundierte Geschäftsentscheidungen zu treffen. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Finanzbranche kann Data Mining eingesetzt werden, um Betrugsmuster zu erkennen und Risikomanagementstrategien zu verbessern. In der Gesundheitsbranche kann Data Mining genutzt werden, um Krankheitsmuster zu identifizieren und die Effektivität von Behandlungen zu verbessern. Insgesamt kann Data Mining in verschiedenen Branchen dazu beitragen, die Geschäftsstrategie zu optimieren und das Marketing effektiver zu gestalten. **
-
Wie kann ein Unternehmen einen rechtskonformen Opt-in-Prozess für die Einwilligung in E-Mail-Marketing aufbauen?
Ein Unternehmen sollte sicherstellen, dass die Einwilligung freiwillig, spezifisch, informiert und eindeutig ist. Dies kann durch die Verwendung eines klaren und verständlichen Opt-in-Formulars erreicht werden. Zudem sollte das Unternehmen eine Dokumentation über den Einwilligungsprozess führen, um im Falle einer Überprüfung durch die Aufsichtsbehörden nachweisen zu können, dass die Einwilligung rechtskonform eingeholt wurde. **
-
Wie funktioniert das Double-Opt-in-Verfahren und warum ist es wichtig für die Zustimmung zu Marketing-E-Mails?
Das Double-Opt-in-Verfahren beinhaltet, dass Nutzer nach der Anmeldung für Marketing-E-Mails eine Bestätigungs-E-Mail erhalten und erst nach Klick auf den Bestätigungslink endgültig in den Verteiler aufgenommen werden. Dies dient dazu, sicherzustellen, dass die Anmeldung tatsächlich vom Nutzer selbst stammt und nicht missbräuchlich erfolgt ist. Durch das Double-Opt-in-Verfahren wird die Zustimmung des Nutzers zu Marketing-E-Mails rechtlich abgesichert und die Wahrscheinlichkeit von Spam-Beschwerden reduziert. **
Ähnliche Suchbegriffe für Cleve-Jürgen-Data-Mining
-
Learning Analytics, Artificial Intelligence und Data Mining in der Hochschulbildung, Fachbücher von Jonas Leschke, Malte Persike, Robert QueckenbergDas Fachbuch "Learning Analytics, Artificial Intelligence und Data Mining in der Hochschulbildung" bietet eine umfassende Analyse der Anwendung moderner Technologien im Bildungsbereich. Es richtet sich an Fachleute, Studierende und Interessierte, die sich mit den Möglichkeiten und Herausforderungen von Learning Analytics und Künstlicher Intelligenz in der Hochschulbildung auseinandersetzen möchten. Die Beiträge, die im Rahmen der Learning AID 2024 entstanden sind, beleuchten verschiedene Aspekte der Datenanalyse und deren Einfluss auf Lehr- und Lernprozesse. Mit einem kartonierten Einband und einer Seitenanzahl von 240 bietet das Buch eine fundierte Grundlage für die Diskussion über die Integration von Data Mining-Techniken in die Hochschulbildung. Die Autoren Robert Queckenberg und Malte Persike bringen ihre Expertise ein, um die Leser über aktuelle Trends und Entwicklungen zu informieren. Verfasst in deutscher Sprache, ist das Buch im Jahr 2025 erschienen und stammt aus Deutschland. Es ist ein wertvolles Werk für alle, die sich mit den geisteswissenschaftlichen Perspektiven auf digitale Bildungstechnologien beschäftigen.39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Pattern Recognition and Data Mining, Fachbücher von Petra Perner, Sameer Singh, Maneesha Apte, Chid PernerDas Fachbuch "Pattern Recognition and Data Mining" von Maneesha Singh und Chid Apte bietet eine umfassende Einführung in die Techniken und Methoden der Mustererkennung und des Data Minings. Mit einem klar strukturierten Ansatz werden grundlegende Konzepte sowie fortgeschrittene Techniken behandelt, die für Studierende und Fachleute im Bereich Technik und IT von Bedeutung sind. Das Buch umfasst 694 Seiten und ist in englischer Sprache verfasst. Es richtet sich an Leser, die ein vertieftes Verständnis für die Analyse von Daten und die Erkennung von Mustern entwickeln möchten. Die erste Auflage, veröffentlicht im Jahr 2005, bietet sowohl theoretische Grundlagen als auch praktische Anwendungen, die in der heutigen datengetriebenen Welt von grosser Relevanz sind. Die kompakte Grösse von 15,5 cm in der Breite und 23,5 cm in der Höhe macht das Buch zudem handlich und leicht transportierbar.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Opt-In und Opt-Out bei der Einwilligung in Marketing-Kommunikation?
Opt-In bedeutet, dass der Kunde aktiv zustimmen muss, um Marketing-Kommunikation zu erhalten. Opt-Out bedeutet, dass der Kunde automatisch Marketing-Kommunikation erhält, es sei denn, er widerspricht ausdrücklich. Opt-In ist also eine aktive Zustimmung, während Opt-Out eine passive Zustimmung ist. **
-
Wie beeinflusst Data Mining die Geschäftsstrategie in verschiedenen Branchen und wie können Unternehmen von den Erkenntnissen profitieren, die durch Data Mining gewonnen werden?
Data Mining ermöglicht es Unternehmen, große Mengen an Daten zu analysieren und Muster sowie Trends zu identifizieren, die für ihre Branche relevant sind. In der Einzelhandelsbranche kann Data Mining beispielsweise dazu genutzt werden, um das Kaufverhalten der Kunden zu verstehen und personalisierte Marketingstrategien zu entwickeln. In der Gesundheitsbranche können durch Data Mining Krankheitsmuster erkannt und präventive Maßnahmen entwickelt werden. Unternehmen können von den Erkenntnissen, die durch Data Mining gewonnen werden, profitieren, indem sie fundierte Entscheidungen treffen, ihre Effizienz steigern und ihre Wettbewerbsfähigkeit stärken. Durch die Nutzung von Data Mining können Unternehmen auch neue Geschäftsmöglichkeiten identifizieren und innovative Produkte oder Dienstleistungen entwickeln, die den Bedürfnissen ihrer Kunden **
-
Wie kann Data Mining dazu beitragen, Muster und Erkenntnisse in großen Datensätzen zu entdecken? Welche Methoden und Techniken werden beim Data Mining eingesetzt?
Data Mining kann dabei helfen, versteckte Muster und Erkenntnisse in großen Datensätzen aufzudecken, indem Algorithmen angewendet werden, um die Daten zu analysieren und Zusammenhänge zu identifizieren. Zu den Methoden und Techniken, die beim Data Mining eingesetzt werden, gehören Clustering, Klassifizierung, Regression, Assoziationsanalyse und Anomalieerkennung. Durch diese Techniken können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. **
-
Warum ist das Double-Opt-in Verfahren wichtig, wenn es um die Zustimmung von Abonnenten für Newsletter und Werbe-E-Mails geht?
Das Double-Opt-in Verfahren stellt sicher, dass die Zustimmung des Abonnenten wirklich absichtlich und bewusst erfolgt. Es schützt vor unerwünschter Spam und sorgt für eine höhere Qualität der Abonnentenliste. Zudem entspricht es den rechtlichen Anforderungen zum Schutz personenbezogener Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.